01
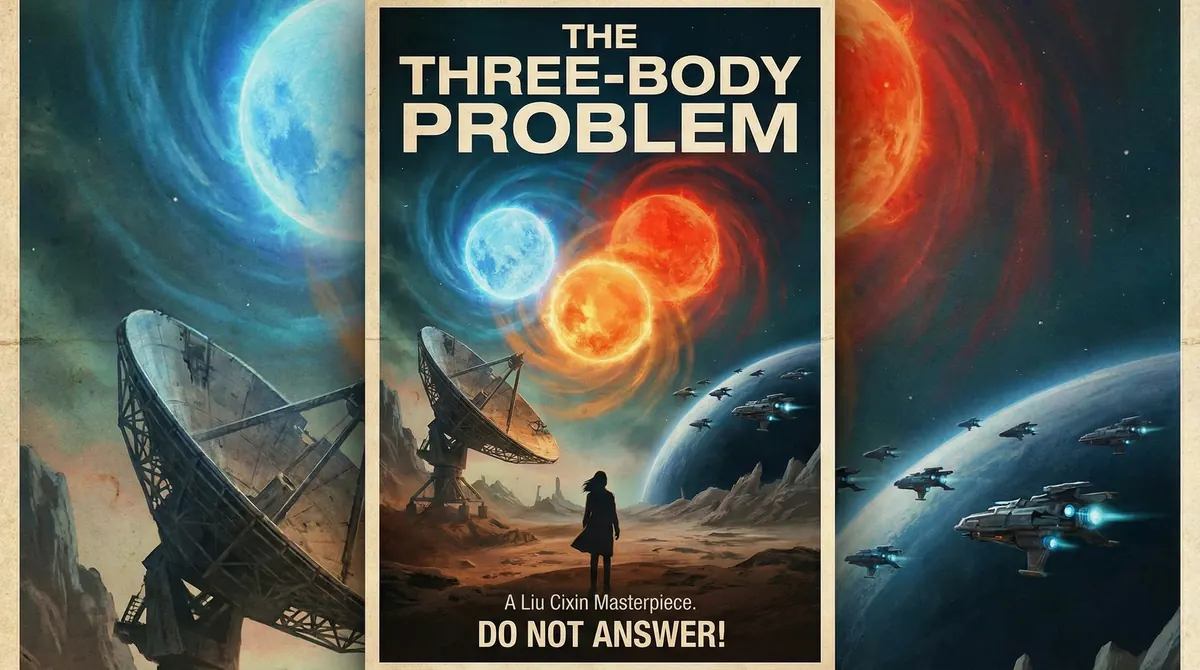
本物の文字が入ったポスターやパッケージ
見出し・ラベル・看板・値札。まず文字を試しましょう。画像モデルがいちばん崩れやすいところです。
絵を説明すれば、最大 4K で返ってきます。3 つのモデルが同じプロンプト欄を共有します。1 つは文字に強く、1 つはセットの統一感を保ち、1 つは速い。作るものに合わせて選びましょう。
クリエイティブワークスペース
テキストから画像とは、文章の説明から絵を生成することです。被写体・構図・ルックを書くと、モデルが描き出します。元になる写真やイラスト、ファイルはありません。
モデルを作った人たちによる説明:
“OpenAI API を使うと、最新の gpt-image-2 を含む GPT Image モデルで、テキストのプロンプトから画像を生成・編集できます。”
テキストから画像 に実際に持ち込まれる仕事と、それぞれに必要な設定です。
見出し・ラベル・看板・値札。まず文字を試しましょう。画像モデルがいちばん崩れやすいところです。
1 つの色調・1 つのレンズ・1 つの光を共有する 6 枚。6 つの別々のプロンプトから生まれたと一目で分かる、良い画像 6 枚ではありません。
誰も撮らないような場所に置いた自社商品。比喩でしか成立しないアイデア。
テキストから画像
テキストから画像 は、結果をいちばん大きく変える少数の設定だけを手前に置き、残りは邪魔にならないようにしています。
01
読める文字には GPT Image 2。セットをそろえたいときは Nano Banana Pro。まだ迷っていて早く答えを見たいときは Nano Banana 2。
02
被写体・構図・光・雰囲気を文章で書きましょう。キーワードからはその平均が返ってきます。描写されたシーンからは構図が返ってきます。
03
1 回あたりが最も安い解像度でアイデアを固め、残した 1 枚だけをフルサイズで再生成しましょう。探索と仕上げに同じ費用をかける必要はありません。
04
16:9 で構成した画像は、9:16 に切り抜くと成り立ちません。最初に決めるほうが後で直すより安く済みます。
05
画像が返ってこなければ、クレジットが戻ります。うまくいかなかった試しにはお金がかかりません。
テキストから画像
テキストから画像 が正解のときと、別のモデルのほうが向いているとき。
スタート地点
白紙
プロンプトが決めること
すべて
こんなときに
まだ元になる画像がないとき
被写体とその動作に 1 文。場所と光に 1 文。形容詞の山は省きましょう。
表示したいとおりに文字を書き、その生成では GPT Image 2 を選びます。
ここで繰り返すのがいちばん安く、1 回に 1 つだけ変えれば、どの変更が効いたか分かります。
同じプロンプト、同じモデル、大きな出力。それが納品するバージョンです。
今ブリーフを整えて、共通のスタジオのワークスペースで続けましょう。